关于 Kitta 的 15 个问答
本文根据《Alibaba Cloud AI Agent Handbook》中的 Kitta 章节整理改写。数据与案例来自原文,标注为“解读”的部分为二次分析。
AI 辅助编程普及之后,代码产出正在快速增长,但审查人力并没有同步扩张。PR 越来越大,评审越来越慢,通用 AI Review 工具又常常给出“看起来很对、实际上没用”的意见。研发效能的瓶颈,正在从“写”转移到“审”。
Kitta 是一套面向领域深度定制的 Code Review Agent。它在龙蜥社区线上运行至今,累计审查超过 7 万个补丁,门禁准确率达到 97%,代码合入率稳定在 62%;其领域定制方法已在六个领域完成验证,带来 17.0%–31.6% 的审查质量提升。
下面用 15 个问题,拆开这套系统为什么这样做,以及它到底解决了什么问题。
一、为什么现在需要 Code Review Agent?
Q1|先用一句话说,Kitta 是什么?
Kitta 不是“更强的通用 Reviewer”,而是一套把通用 Agent 领域化的 Code Review Agent。
它从项目真实研发历史中沉淀专家资产,再定制审查流程和领域知识,最后通过线上线下的协同闭环持续进化。目标不是替代 Maintainer 做最终决定,而是把可定位、可验证的风险和证据,提前送到人和流程面前。
从结果看,Kitta 已经不只停留在 Demo 阶段:龙蜥社区累计审查 7 万+ 补丁,门禁准确率 97%,代码合入率 62%;在操作系统内核、编译器、文件系统、网络系统、云原生平台、AI 计算框架六个领域,审查质量提升在 17.0%–31.6% 之间。
Q2|AI 都能写代码了,Review 为什么反而更重要?
因为“写”的产能被放大了,“审”的产能没有。
原文给出了三组很有代表性的信号:
- Linux 内核需要修复的 CVE 数量快速攀升:6.9–6.19 大致在四五百的区间,7.0 已约 1250,7.2 接近 1900,原文预计 7.3 会超过 2000。
- 全行业 CVE 同比增长 394%,高危 CVE 同比增长 811%(数据来源:Linux Foundation《The CRA Readiness Reality: What Changed and What Didn’t Between 2025 and 2026》)。
- DORA 报告显示,AI 深度参与开发的同时,代码 Bug 率 +9%,代码评审时间 +91%,平均 PR 体积 +154%。这组数字是相关性口径,不是严格的因果结论,但趋势很明确。
龙蜥社区 ANCK 内核仓库的 PR 合入量,也在 AI Agent 引入后持续攀升。
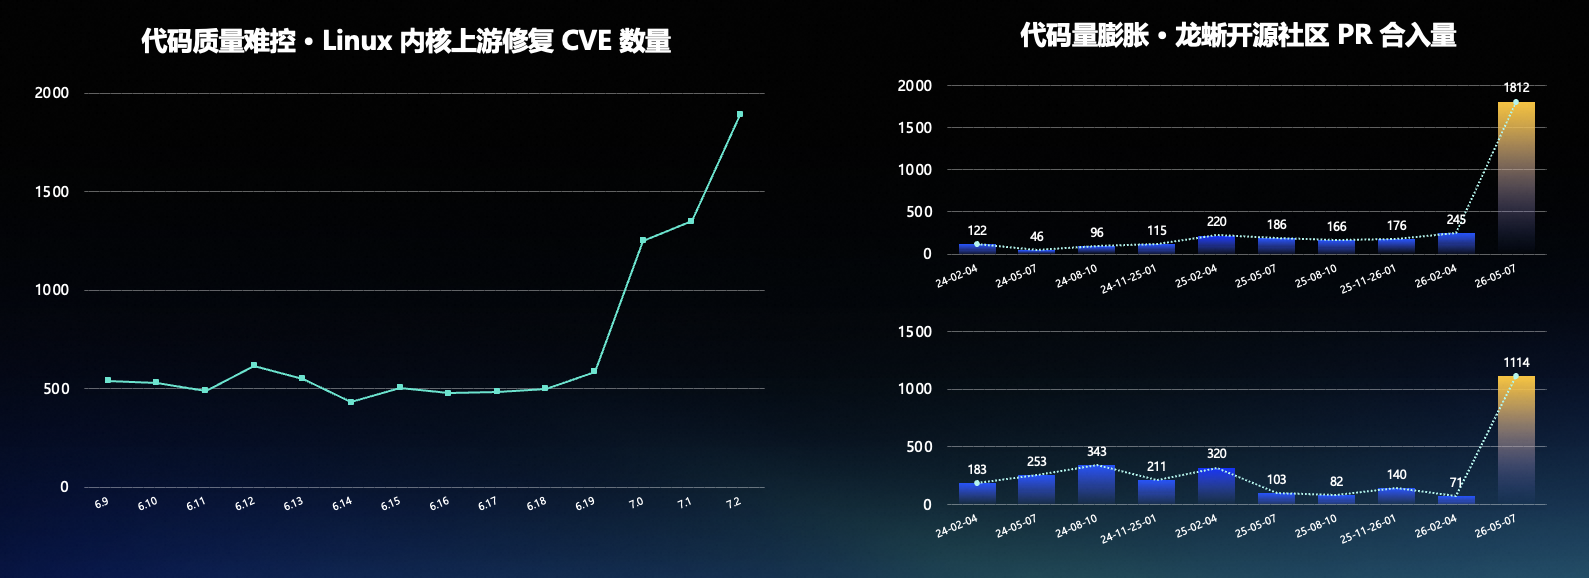
图 1:左侧为 Linux 内核上游修复 CVE 数量,右侧为龙蜥社区 ANCK 仓库两个版本的 PR 合入量。
放到 Agentic CI 的完整链路里看,代码评审正好处在承上启下的位置:上游是 AI 协同编程,下游是智能化测试和社区审核合入。评审如果失守,要么缺陷漏到下游,要么 Maintainer 被人机共写产生的 PR 洪流淹没。
Q3|通用 AI Review 工具,究竟差在哪?
一句话:AI 能“看懂”代码,却未必“看懂”项目。
原文把通用方案的局限拆成两个维度。
第一是工程行为约束不足:
- 变更较大时只评审部分文件,覆盖不全;
- 报告的问题和实际代码位置对不上,出现位置漂移;
- 评审质量随提示词的细微差异大幅波动,效果不稳定。
第二是检查深度不足:
- 缺乏对审查项目的语义理解,规则浮在表面;
- 对每个项目、每次评审一视同仁,感知不到项目特有的审查需求。
再往下拆,是三个深层挑战:
- 领域知识匮乏。 通用模型见过很多代码,但未必懂内核的锁语义,也未必懂编译器的中间表示约定。
- 业务理解不足。 社区开源项目、企业内部仓库、发行版维护,“什么算问题、问题有多严重”的标准完全不同。
- 信任边界模糊。 用户说“好”不一定是真的好,Agent 自我感觉良好更靠不住;没有客观评估和进化闭环,信任就建立不起来。
Q4|那 Kitta 的“领域定制”具体指什么?
把通用 Agent 领域化,分三步走。
- 项目级专家资产管理:从真实评审与缺陷记录中提炼“按什么标准判”和“判得对不对如何度量”。
- 双轮驱动的审查定制:流程定义“看哪里”,知识决定“怎么看”。
- 在线离线协同进化:离线用验证样本校准,线上用真实代码行为校准。
这三步不是一次性的 Prompt 调优,而是把评审能力工程化、资产化、可迭代化。
二、Kitta 怎么让 AI “看懂项目”?
Q5|为什么第一步是“项目级专家资产”?
因为领域知识不是凭空写出来的,而是从真实历史里提炼出来的。
Kitta 会从社区研发历史中的真实评审与缺陷记录出发,覆盖 GitHub 仓库等多源数据。原始记录经过采集关联、规整去噪、语义解析、隔离复现,最后沉淀为项目级专家资产。
其中“隔离复现”很关键:它要求每一条缺陷模式和预期结论都可验证、经得起追问,而不是把噪音当成经验。
这份资产包含两类核心内容:
- 评判标准:评审原则、缺陷模式、项目惯例,回答“按什么标准判”;
- 验证样本:问题样本、正常样本、预期结论,回答“判得对不对如何度量”。
可以把它理解成给 Agent 准备了一套该项目的“判例集”,而不是塞一本通用规范。换一个新项目,同一条管线可以把它的真实历史重新提炼成新的专家资产。这一步的本质,是让“懂行”从个人经验变成组织能力。
Q6|“双轮驱动”到底指什么?
流程决定“看哪里”,知识决定“怎么判”。
流程这一轮,Kitta 定义了四个审查维度:
- 语义一致性:防止补丁行为与预期背离;
- 回合完整性:盯住跨版本补丁序列是否完整、有没有遗漏;
- 发行版规范:把关是否符合发行版的合入要求;
- 集成风险:评估变更进入代码库后的连带影响。
知识这一轮,则依托多源头、层次化的知识库,做子领域拆分,沉淀典型缺陷模式,让 Agent 的判断贴合该领域专家的真实经验,而不是泛泛的“最佳实践”。
这两个轮子缺一不可:只有流程,容易退化成一张检查清单;只有知识,没有固定视角,又会漏项。解读来说,Kitta 的思路是把“专家怎么审”拆成可执行的流程,再把“专家为什么这么判”沉淀成可检索、可验证的知识。
Q7|为什么“补丁回合”值得单独做一套审查?
因为回合补丁最容易出现“看起来对、实际上错”的问题。
补丁回合是下游内核社区的高频操作:把上游补丁回合到下游时,往往要根据下游上下文做适配。既要判断适配是否正确,也要确认回合是否完整,有没有把上游后续的修复一并带回来。
围绕这个场景,Kitta 定制了两项内核特定检查。
第一是补丁语义一致性检查:
- 先微观溯源,比对补丁级差异;
- 再宏观评估,判断整体功能是否一致。
这样做的目的,是避免“逐行都对、整体变了”的漏判。
第二是补丁完整性检查:
- 智能追踪回合补丁的上游依赖链;
- 自动识别上游对应的 Fixes 补丁;
- 通过四阶段遗漏 Fixes 检索流程,排查是否把已知漏洞重新引入下游。
除代码本身,Kitta 还覆盖 PR 描述规范、描述与代码一致性等流程类审查项。因为在下游产品化流程里,代码质量只是其中一个环节。
Q8|“看得深”靠的是更大的模型,还是更好的 Prompt?
靠分层知识库,加上一套更“较真”的审查流程。
在 ANCK 的落地中,知识定制主要做了三件事:
- 内核领域数据工程:收集多来源知识,经过筛选、合成、均衡等流水线,得到领域知识库和 Benchmark 数据。
- 子系统专用知识库:内核不同子系统的评审关注点差异很大,按子系统组织知识,让评审贴合各子领域的真实惯例。
- 深度审查流程:引入“有罪推定—全栈调用链分析—自我辩论”的审查方式。
所谓“有罪推定”,不是预设开发者有错,而是先假设这段代码可能有问题,沿着全栈调用链追语义,再通过自我辩论验证结论。相比直接问模型“这里有没有 Bug”,这种流程更不容易被表面正确的代码骗过去。
Q9|怎么证明它真的变强了,而不是“自嗨”?
用贴近真实评审分布的 Benchmark,而不是只看几个漂亮 Demo。
Kitta 的评估数据来自三类来源:
- LKML:真实社区 Reviewer 的评审过程,问题分布均匀、真实性强;
- sashiko benchmark:单 commit 对单 issue,映射精确;
- 龙蜥社区数据:把评估拉回 Kitta 实际服务的仓库语境。
三类数据各司其职:LKML 对齐真实 Reviewer 的判断标准,sashiko 让能力改进方向足够聚焦,龙蜥数据保证评估不脱离实际业务。
在此基础上,Kitta 还与 sashiko、review-prompts、qoder 等 SOTA 方案做横向对比,看清自己在特定缺陷类型、特定子系统上的差距,再把这些差距转化为 Skill 迭代的优先级。
Q10|上线之后,它怎么越用越准?
离线用验证样本校准,线上用真实代码行为校准。
离线侧,用验证样本做隔离评测,根据结果反思进化,持续校准 Agent 的判断标准。
线上侧,则基于 Review 意见内容和研发的后续代码行为,分析各类意见是否真正有效,并结合 Review 采纳率持续监控、更新知识、迭代校准和调整阈值。
这里有一个很重要的原则:不把开发者的默默无视当成认可。 用户可能不说话,但代码改了什么不会骗人。用客观变更驱动审查和模型迭代,比收集“好评”可靠得多。
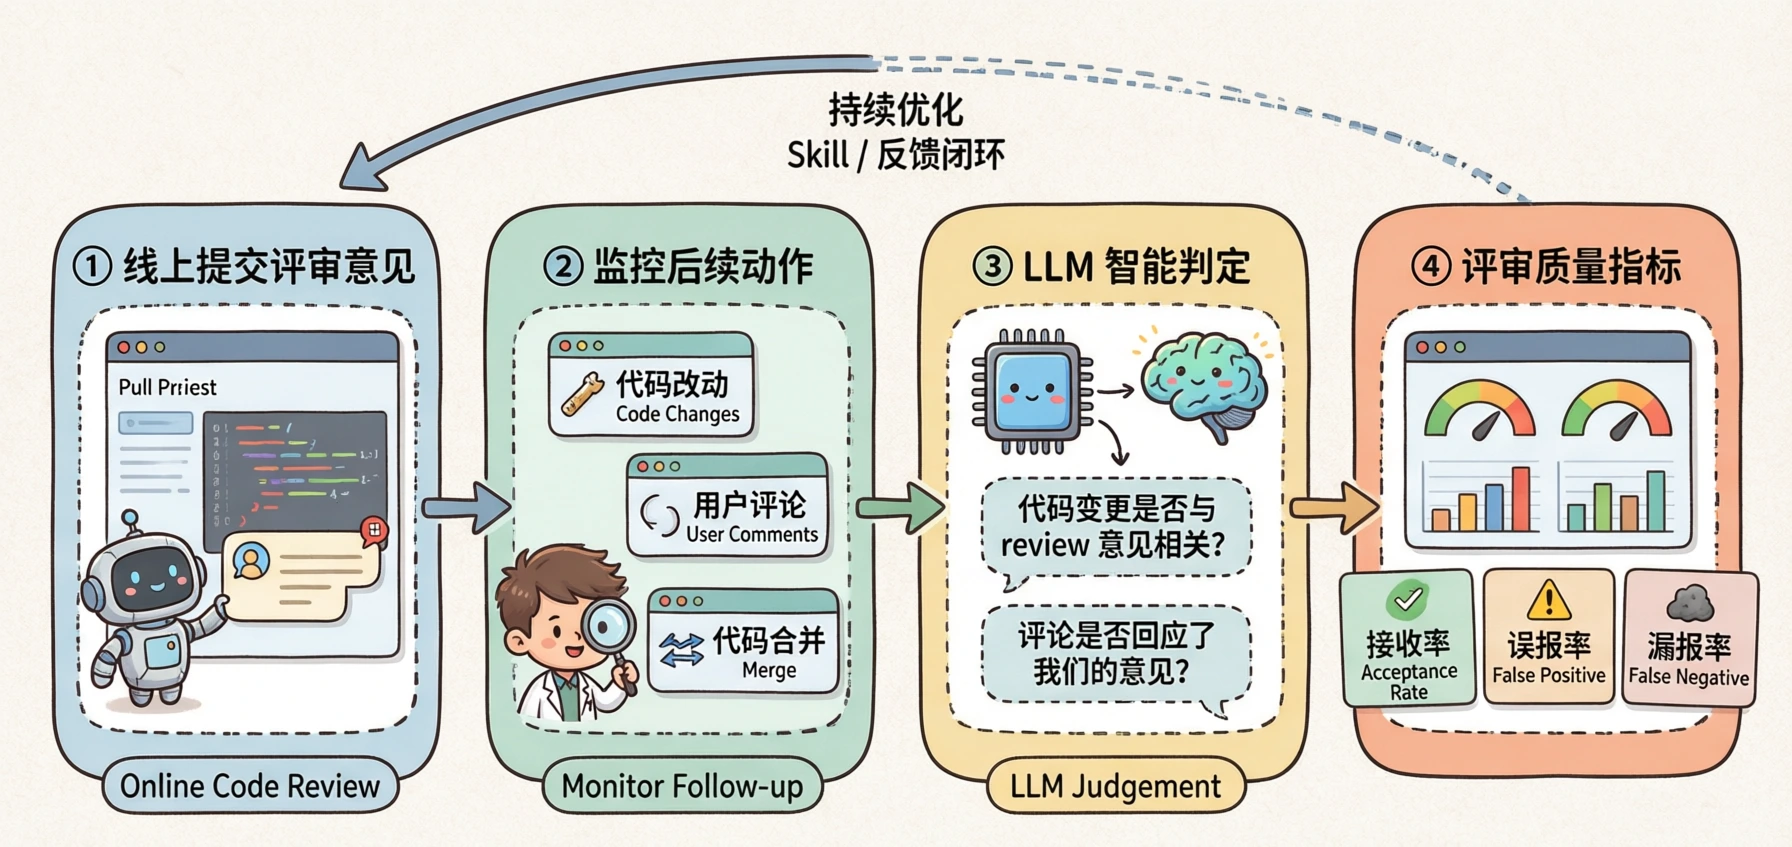
图 2:线上评审意见从提交、监控后续动作,到 LLM 判定相关性和度量质量指标的闭环。
三、落地之后,实际效果如何?
Q11|一个 PR 进来,Kitta 实际会经历什么?
会沿着一条五阶段流水线,从“分类”走到“代码质量”。
开发者提交 PR,或在评论中输入 /check-code-review,审查任务就会被触发。
- PR 分类。 判断是纯自研补丁还是回合补丁。如果 Commit 中存在类似
commit xxxx upstream的上游补丁声明,就归为回合补丁。分类决定后续检查范围,纯自研补丁不会执行补丁完整性检查和回合一致性检查,避免不必要的开销。 - PR / Commit Message 规范性检查。 基于社区规范文档,检查 PR 描述、Commit Title、Commit Message。没有问题不报告;有问题则给出修改建议。
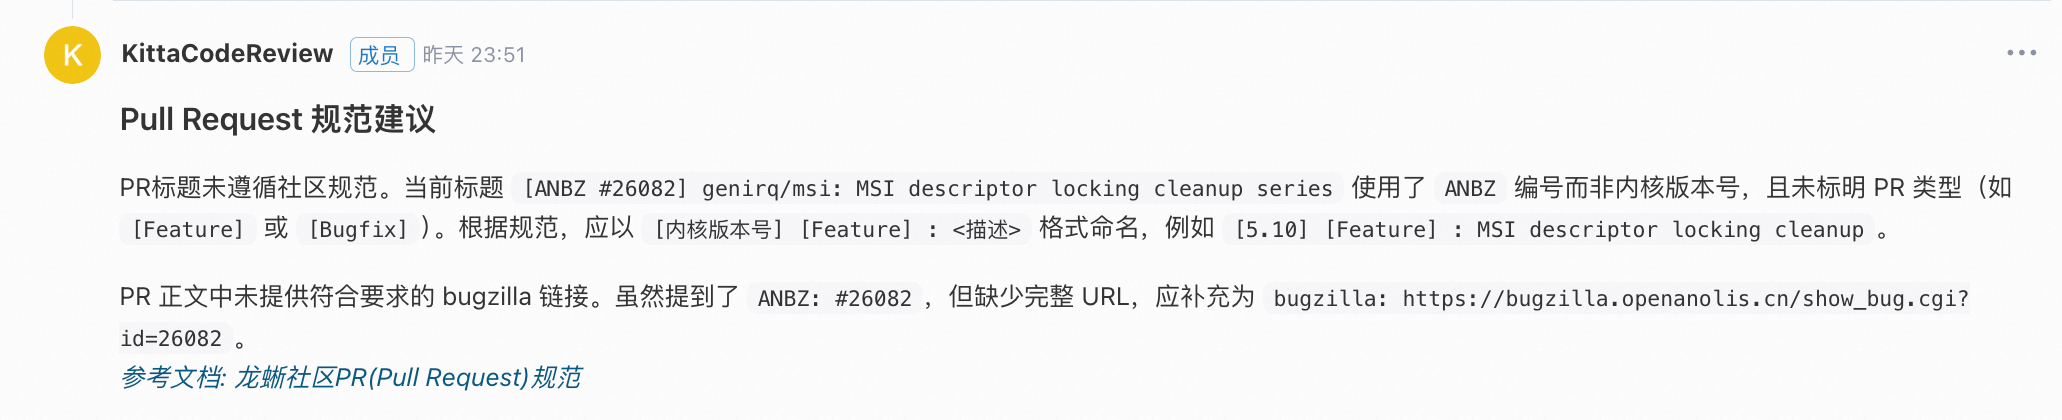
图 3:PR 规范检查会指出标题格式、PR 类型和 bugzilla 链接等具体问题。
- 补丁完整性检查。 针对回合补丁,追踪上游依赖链,按“检索上游 Fixes → 判断是否在 PR 中 → 判断是否已存在于下游仓库”的流程排查。结果分为无遗漏 Fixes、已合入的 Fixes 补丁、遗漏的 Fixes 补丁。
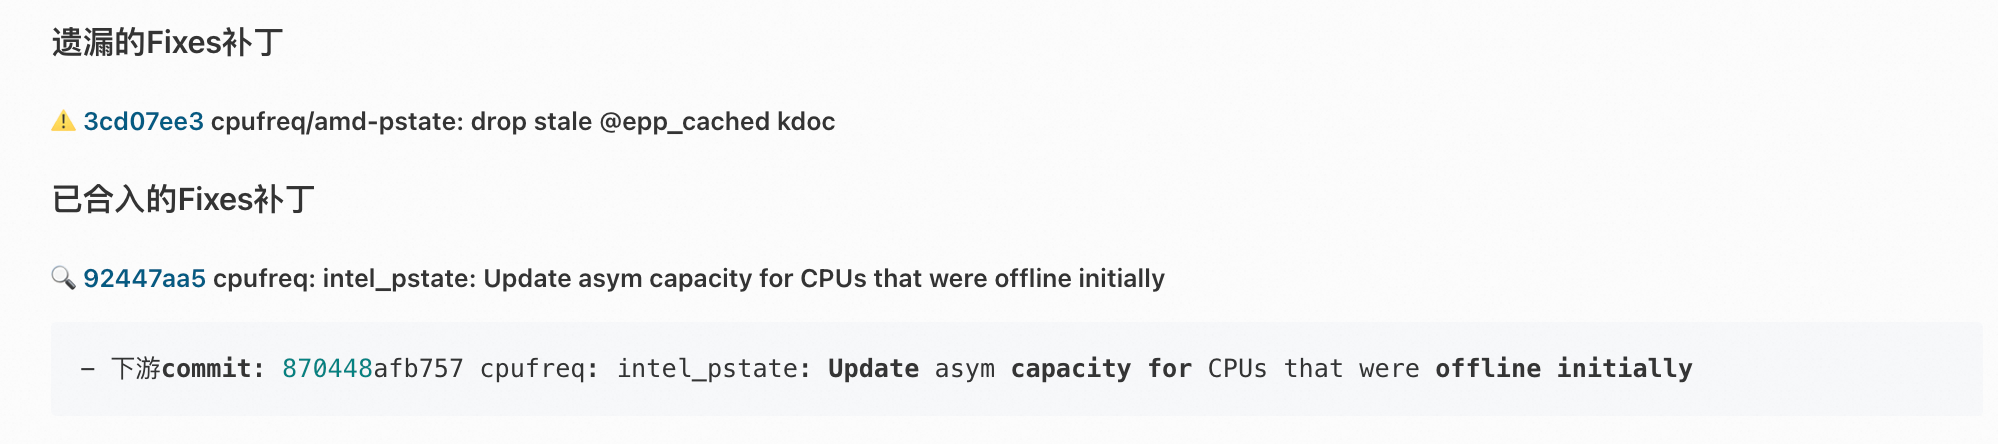
图 4:补丁完整性检查会分别列出遗漏的 Fixes 和已合入的 Fixes,并给出下游 commit 对应关系。
- 补丁回合一致性检查。 先获取上游原补丁,再从三个层次对比:基础对比看修改的文件和代码块;上下文对比看符号、函数、变量定义是否一致、适配是否合理;语义对比则由 LLM 判断上下游补丁是否实现相同功能和语义。结果从
consistent到text-inconsistent、semantic-inconsistent、inconsistent分层输出。 - 代码质量审查。 问题按严重程度分为
Critical和Medium / Low。Critical 通常会以内联评论定位到具体代码行,需要开发者处理或明确是否为误报;未发现风险则给出LGTM。
这条流水线的设计重点,不是“每一步都让模型自由发挥”,而是先用分类缩小范围,再用固定流程保证覆盖,最后才把判断交给模型。
Q12|效果数据到底怎么样?
核心指标很亮眼,但两类场景要分开看。
Kitta 上线至今的运行数据:
| 指标 | 数值 |
|---|---|
| 审查规模 | 7 万+ |
| 门禁准确率 | 97% |
| 代码合入率 | 62% |
基于线上评估框架,对 Kitta 上线以来处理过的所有已合入 PR 做回溯统计,两类核心场景的表现是:
- 回合补丁场景:一致性检查意见采纳率 70.4%,准确率 99.8%;
- 自研 PR 场景:Code Review 意见采纳率 41.8%,准确率 73.6%。
两组数字差异很大。一个合理解释是:回合补丁有上游原补丁作为参照,问题边界更清楚,更容易验证;自研 PR 更开放,什么算问题、问题有多严重,本身就更依赖项目语境和人工判断。因此,自研场景的数字更低,并不意味着没有价值,而是说明它更难,也更需要人类兜底。
从工作方式上看,Kitta 的介入让大量问题在进入人工审查前就被识别,并给出可定位、可验证的修改建议。很多 PR 在收到意见后,开发者会直接补充依赖补丁或调整实现,减少了 Maintainer 反复追问、来回确认的回合数。Maintainer 的注意力,可以从“逐行看变更”转向“判断关键争议点”。
Q13|这套方法只能用于内核吗?
方法论可以迁移,但不是“一套 Prompt 打天下”。
Kitta 已经把专家资产和审查流程抽象为可迁移的 Skill,并在六个领域完成验证:
| 领域 | 审查质量提升 |
|---|---|
| 操作系统内核 | 20.4% |
| 编译器 | 24.4% |
| 文件系统 | 17.0% |
| 网络系统 | 19.8% |
| 云原生平台 | 31.6% |
| AI 计算框架 | 21.7% |
这些领域的共同特点是代码规模大、语义深、审查门槛高,传统通用 Review 工具往往给不出有价值的结论。
跨领域的稳定提升说明,“领域定制”的方法论是通用的:内核的锁语义、编译器的中间表示、云原生平台的配置约定,都可以通过沉淀专家资产、定制审查流程来构建专家级 Review 能力。但每个领域仍然需要重新做资产和流程,不能指望一套通用规则包打天下。
四、AI Review 的边界在哪里?
Q14|AI 会不会取代 Maintainer?
不会。AI 是探照灯,Maintainer 是方向盘。
Kitta 的实践遵循三条原则。
第一,精准分级,克制打扰。 对安全漏洞和破坏性变更坚决拦截 CI 流程,这是底线;其余问题分级呈现、仅作提示,不过多占用开发者注意力。
第二,行为作证,拒绝自嗨。 不把沉默当认可,通过置信度熔断和追踪真实代码变更,基于客观行为驱动审查和模型迭代。
第三,人类兜底,适时退场。 AI 负责照亮风险、给出证据,最终决策权仍然在人。Maintainer 是最后一道防线。
所以,AI Review 的目标不是让评论数量越来越多,而是让人从重复劳动里退出来,把注意力留给真正需要判断的争议点。
Q15|如果我的团队也想落地,第一步该做什么?
先找一个“高频、可验证、历史数据充足”的场景,不要一上来追求全仓库覆盖。
结合 Kitta 的实践,可以拆成五步(以下为落地建议,不是原文结论):
- 选场景。 优先选回合补丁、依赖升级、接口兼容性、发布规范检查这类重复性高、判断标准相对明确的任务。
- 挖历史。 收集过去半年到一年的 Review 评论、缺陷记录、回滚记录、Fixes 补丁,找出“项目真正在意什么”。
- 写流程。 把审查拆成固定视角和检查顺序,先保证看得全,再谈看得深。
- 建样本。 准备一批带预期结论的验证样本,既包括问题样本,也包括正常样本,避免只测“能不能挑错”。
- 小范围试点。 先以建议模式运行,跟踪意见采纳率和后续代码变更;稳定后再把 Critical 问题接入门禁。
核心不是一开始就做多大,而是先让一个场景变得可衡量、可迭代,再把方法复制到下一个领域。
写在最后
回到开头的问题:AI 时代为什么还需要 Code Review Agent?
因为代码生产得越快,判断“这段代码能不能进主干”就越贵。通用模型可以帮你发现一些显性问题,但真正难的,是项目特有的语义、流程、惯例和风险边界。
Kitta 给出的答案是把通用 Agent 领域化:用真实历史沉淀专家资产,用流程和知识双轮定制,用 Benchmark 和线上行为持续校准,最后把最终决定权留给 Maintainer。
好的 AI Review,不是让 AI 说得更多,而是让人看得更少、更准。
发布用摘要
AI 写代码越来越快,但 Review 的人没有变多。Kitta 是一套面向领域深度定制的 Code Review Agent:它从项目真实评审历史中沉淀专家资产,用“流程 + 知识”双轮定制审查能力,再通过线上线下闭环持续进化。本文用 15 个问答,拆解它如何把 AI Review 从“能用”推进到“敢用”。
配图建议
- Agentic CI 四环节图:AI 协同编程 → 智能化代码评审 → 智能化测试 → 社区审核合入,突出评审承上启下的位置。
- 三步走方法论图:专家资产 → 双轮定制 → 在线离线进化,做成闭环。
- 五阶段流水线图:PR 分类 → Message 规范 → 完整性 → 一致性 → 代码质量,标出每阶段的输出。
发布前建议核对
- 原文开头写“操作系统内核、编译器、Agent 平台型应用等六大领域”,但 4.3 表格写的是“AI 计算框架”。本文采用表格口径,发布前建议统一。
- “合入率 62%”建议明确是“代码合入率”还是“PR 合入率”,避免读者误解。
- “7 万+”在原文中有“补丁”和“审查规模”两种表述,本文统一为“补丁”,发布前可按实际口径调整。
- Linux 内核 CVE 版本数字、DORA 的 +9% / +91% / +154% 建议回链原始报告,并保留“相关性口径”的说明。
- 原文 4.4 末尾有一句重复(“反哺基座模型更基础的能力。”),本文已删除。
- 原文 Stage 4、Stage 5 两处配图在源 Markdown 中已经是 1×1 的空白 SVG 占位,无法还原实际截图;本文保留了其余四张有效图片,这两处如需发布配图,建议从原文页面补回。
原文出处
- 《Alibaba Cloud AI Agent Handbook》:https://github.com/aliyun/ai-agent-handbook
- 配图取自同一仓库
assets/imgs/chapter-25/(Apache-2.0 许可)
大家在聊 (0)
加载评论中...
还没有人留言
快来抢占沙发