DeepSeek 把 Agent 的「眼睛」卖到了 5 元/千次
拆解 DeepSeek 搜索 API,以及 Claude、ChatGPT、GLM、豆包、Gemini 的六套联网方案
10 月 17 日,DeepSeek 随 V4.1 Flash 发布了一篇并不起眼的更新公告,其中一节叫「开放自研搜索 API」。
第一反应是:搜索 API 满大街都是,这有什么好发的?
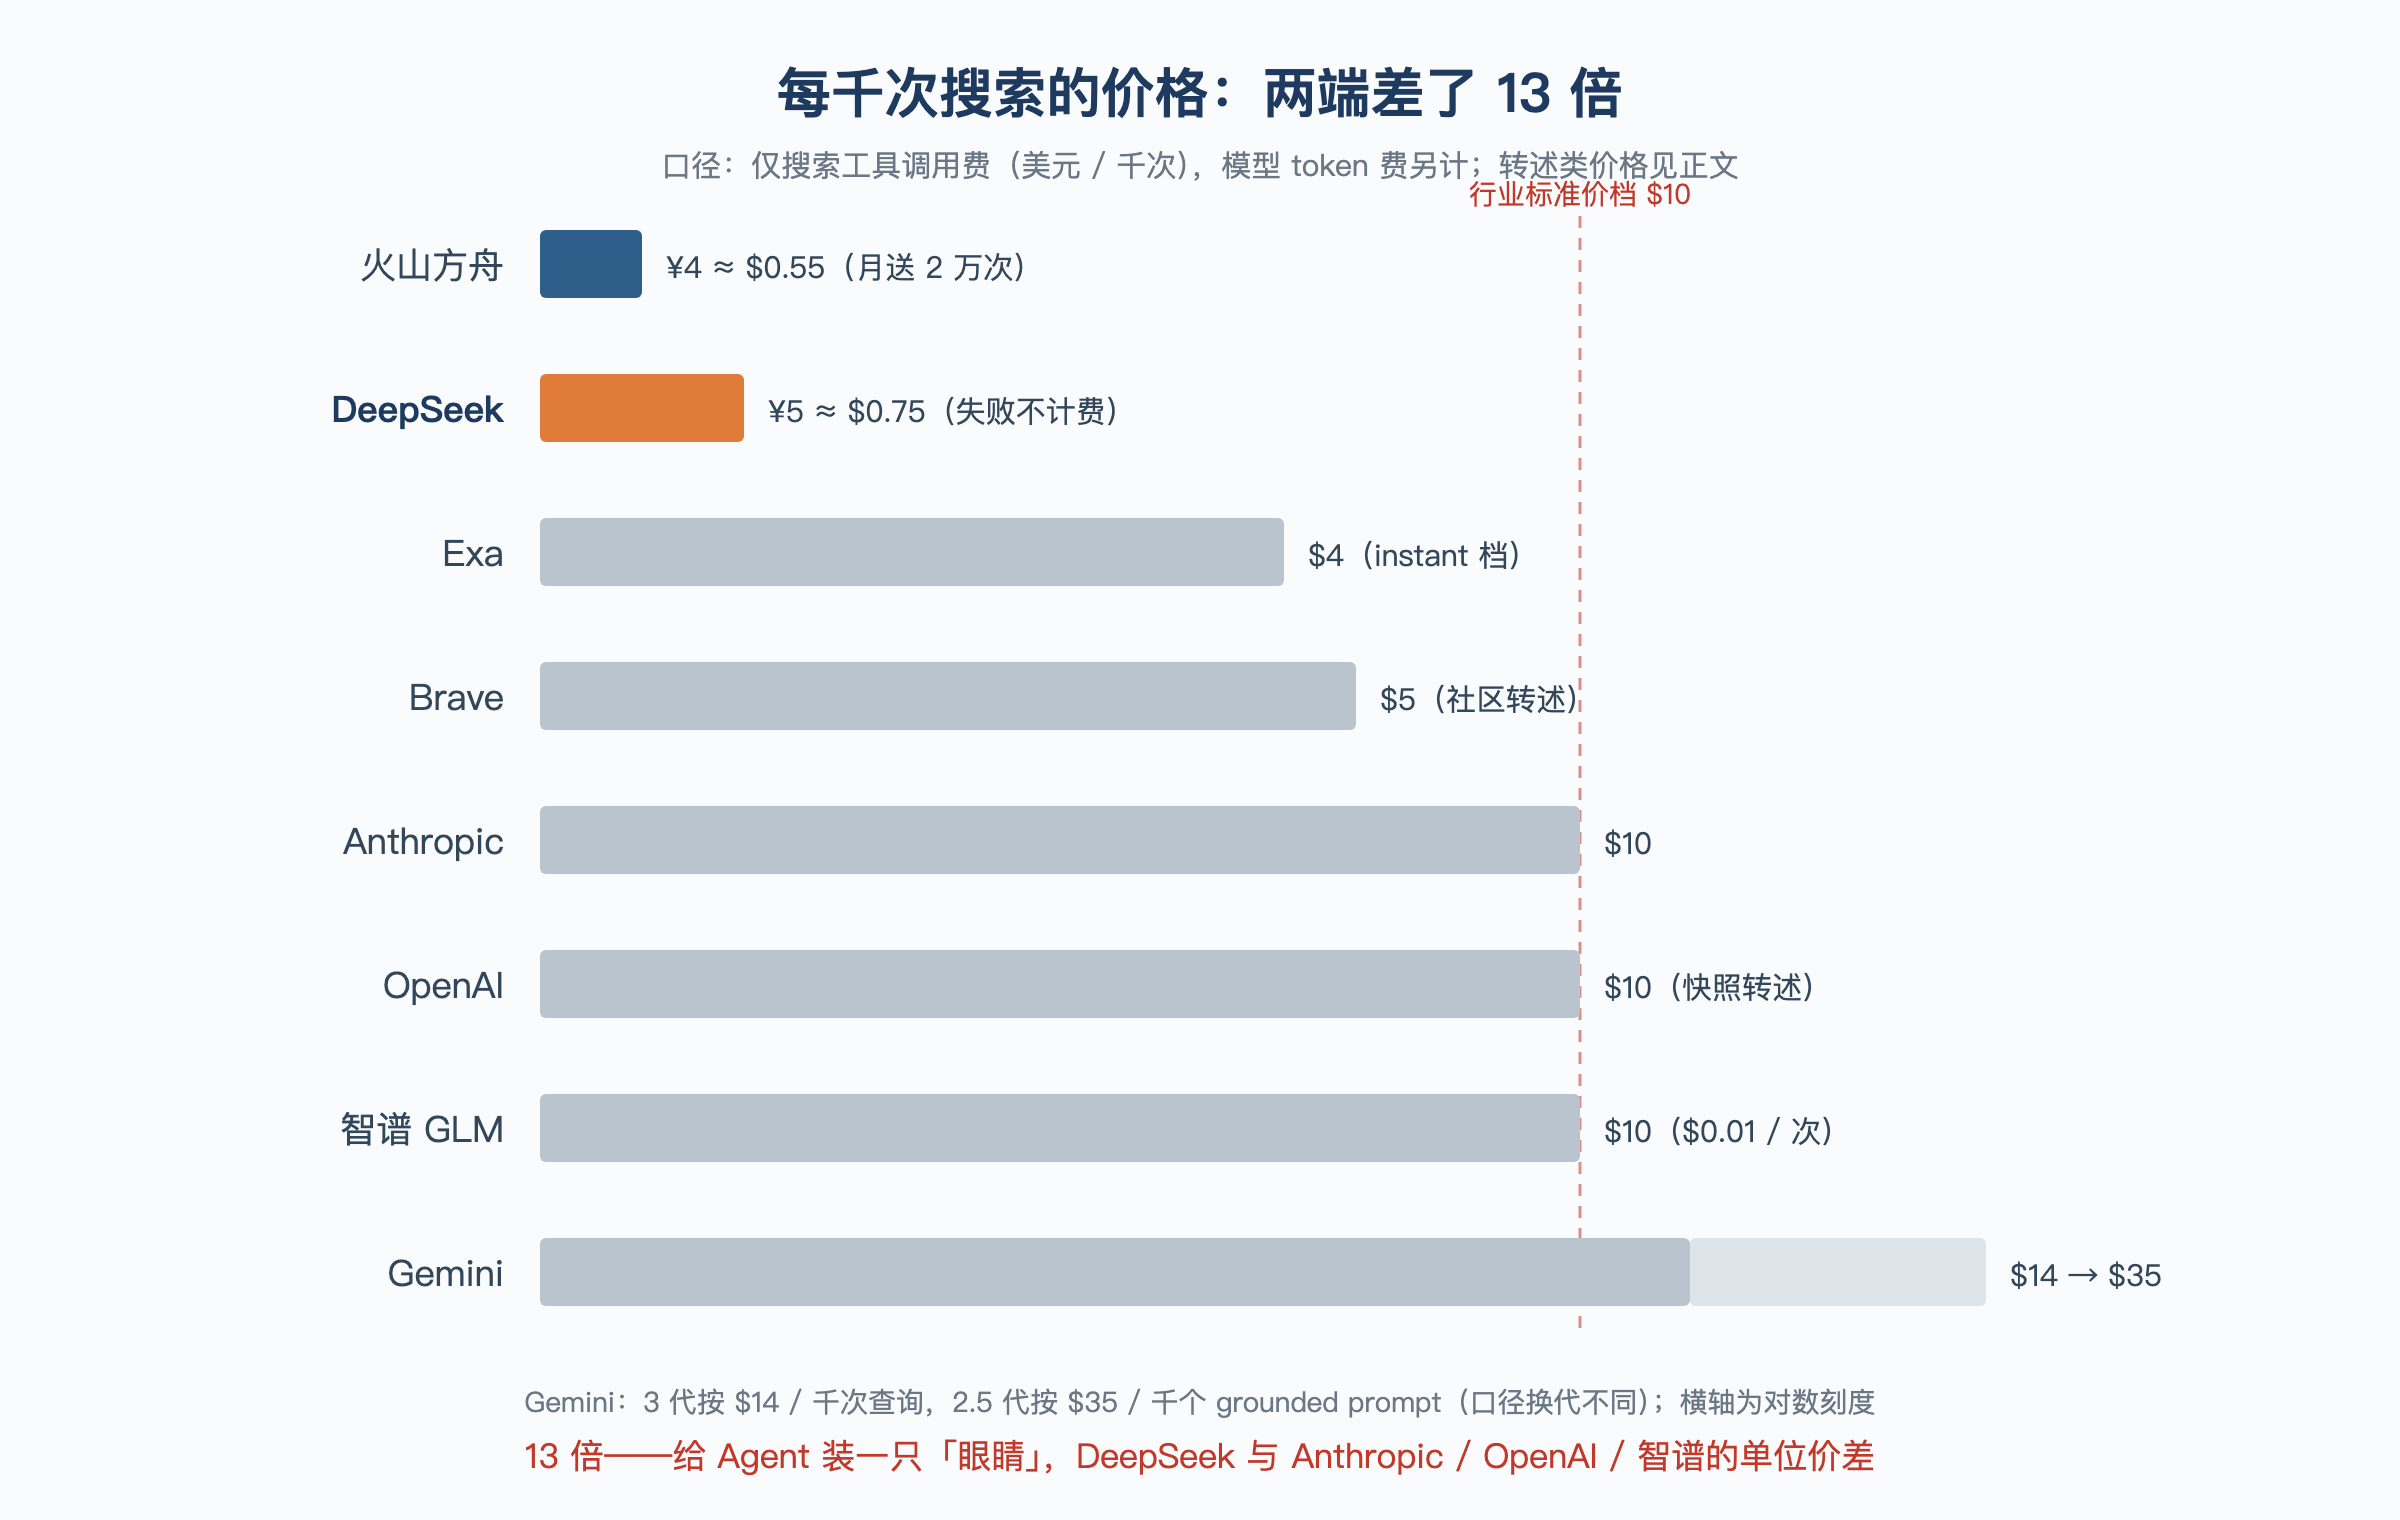
把文档翻完,又把六家「模型 + Agent 工具」的联网方案逐项对了一遍账之后,判断变了:这是给 Agent 装「眼睛」这件事,第一次被标到了成本价——每千次搜索 5 元人民币,约为 Anthropic、OpenAI、智谱同项价格的十三分之一。
这篇文章讲三件事:
- DeepSeek 这两个接口,和传统
websearch/webfetch工具有什么本质区别; - 它此前是怎么做联网的;
- DeepSeek、Claude、ChatGPT、GLM、火山豆包、Gemini 六套方案,各自长什么样。
说明:本文涉及的接口、价格与产品形态,口径均截至 2026 年 10 月 17 日。部分海外厂商定价来自社区快照转录,文中会单独标注。
一、发生了什么:把「眼睛」做成了商品
两个新接口,和 DeepSeek 对话 API 共用同一套鉴权、同一个账户余额:
- Search(
POST /v1/tools/search):按搜索词搜网页,返回结构化结果,由 DeepSeek 自研搜索引擎提供支持。 - Fetch(
POST /v1/tools/fetch):抓取单个网页,直接返回 Markdown 正文。
接口本身不稀奇,稀奇的是返回字段的设计。
返回字段:真正的差异在「给模型读」
| 字段 | 内容 | 用途 |
|---|---|---|
snippet | 约 100–200 字符的短摘要 | 给人看的预览 |
summary | 约 600–800 字符的长摘要 | 给模型读的「书报」 |
content | 网页正文全文,需参数开启 | 免去二次抓取 |
rerank_score | 0–3 分,官方称 1.5 以上为优质 | 引擎内部相关性打分 |
authority | 0–4 级,3 级以上为「极权威」 | 站点可信度分级 |
搜索语法支持 site、lang、日期范围等操作符,单次最多返回 50 条。
公告里还有一段规模自述:引擎「长期支撑网页端与 API 端,稳定处理每天来自全球各地的数亿次搜索请求」,「索引了全球千亿级网页」,并能识别过滤 SEO 作弊与低质 AIGC 内容。这些数字均为官方口径,没有第三方审计,后文涉及类似数据时也应保留这个折扣。
价格:按成功请求计费
每千次成功请求 5 元(英文文档同口径为 $0.75),Search、Fetch 分开计费,不按 token、不按条数;只有 HTTP 200 且有结果的请求才计费——搜不到不收钱,抓不到不收钱。
两个接口各限 5 QPS,按账号粒度计算。
对 Agent 开发者更要紧的时间点:公告写明,在 DeepSeek Harness、Claude Code、Codex 中通过 server 端工具调用产生的搜索与抓取,目前免费;北京时间 2026 年 11 月 1 日 00:00 起按次收费。免费体验期只剩两周。
一个需要澄清的说法
如果你看到「DeepSeek 把搜索后端从 Bing/搜狗换成了自研」这类转述——翻遍官方公告、HN 讨论和历史资料,没有找到可靠信源支持这个说法。
官方叙事恰恰相反:网页端和 API 端「长期」都由自研引擎支撑。这次公告做的是把内部能力开放成商品,不是换零件。
真正的新意有两处:
- 开发者第一次可以单独调用它,并且拿到打分、权威级、正文三层粒度;
- 计费正式化了。
二、之前怎么做:传统「两跳」链路
三层前史
DeepSeek 的联网能力可以分三层看:
- 聊天产品层:网页版一直有内置联网搜索,但不成 API、不可编程。
- 开发者层:DeepSeek 的模型 API 此前没有官方搜索工具。想做联网 Agent,只能自己接第三方——今年 2 月 Hacker News 上就有用户抱怨,调 DeepSeek API 做联网任务要外挂
serper.dev这类搜索接口。 - Harness 层:它自家的开源工具 dsh,以及接入 DeepSeek 的 Claude Code 和 Codex,其实早已在服务端调用这两个接口。这也是公告能提前把计费开关立好的原因。
传统做法:两跳
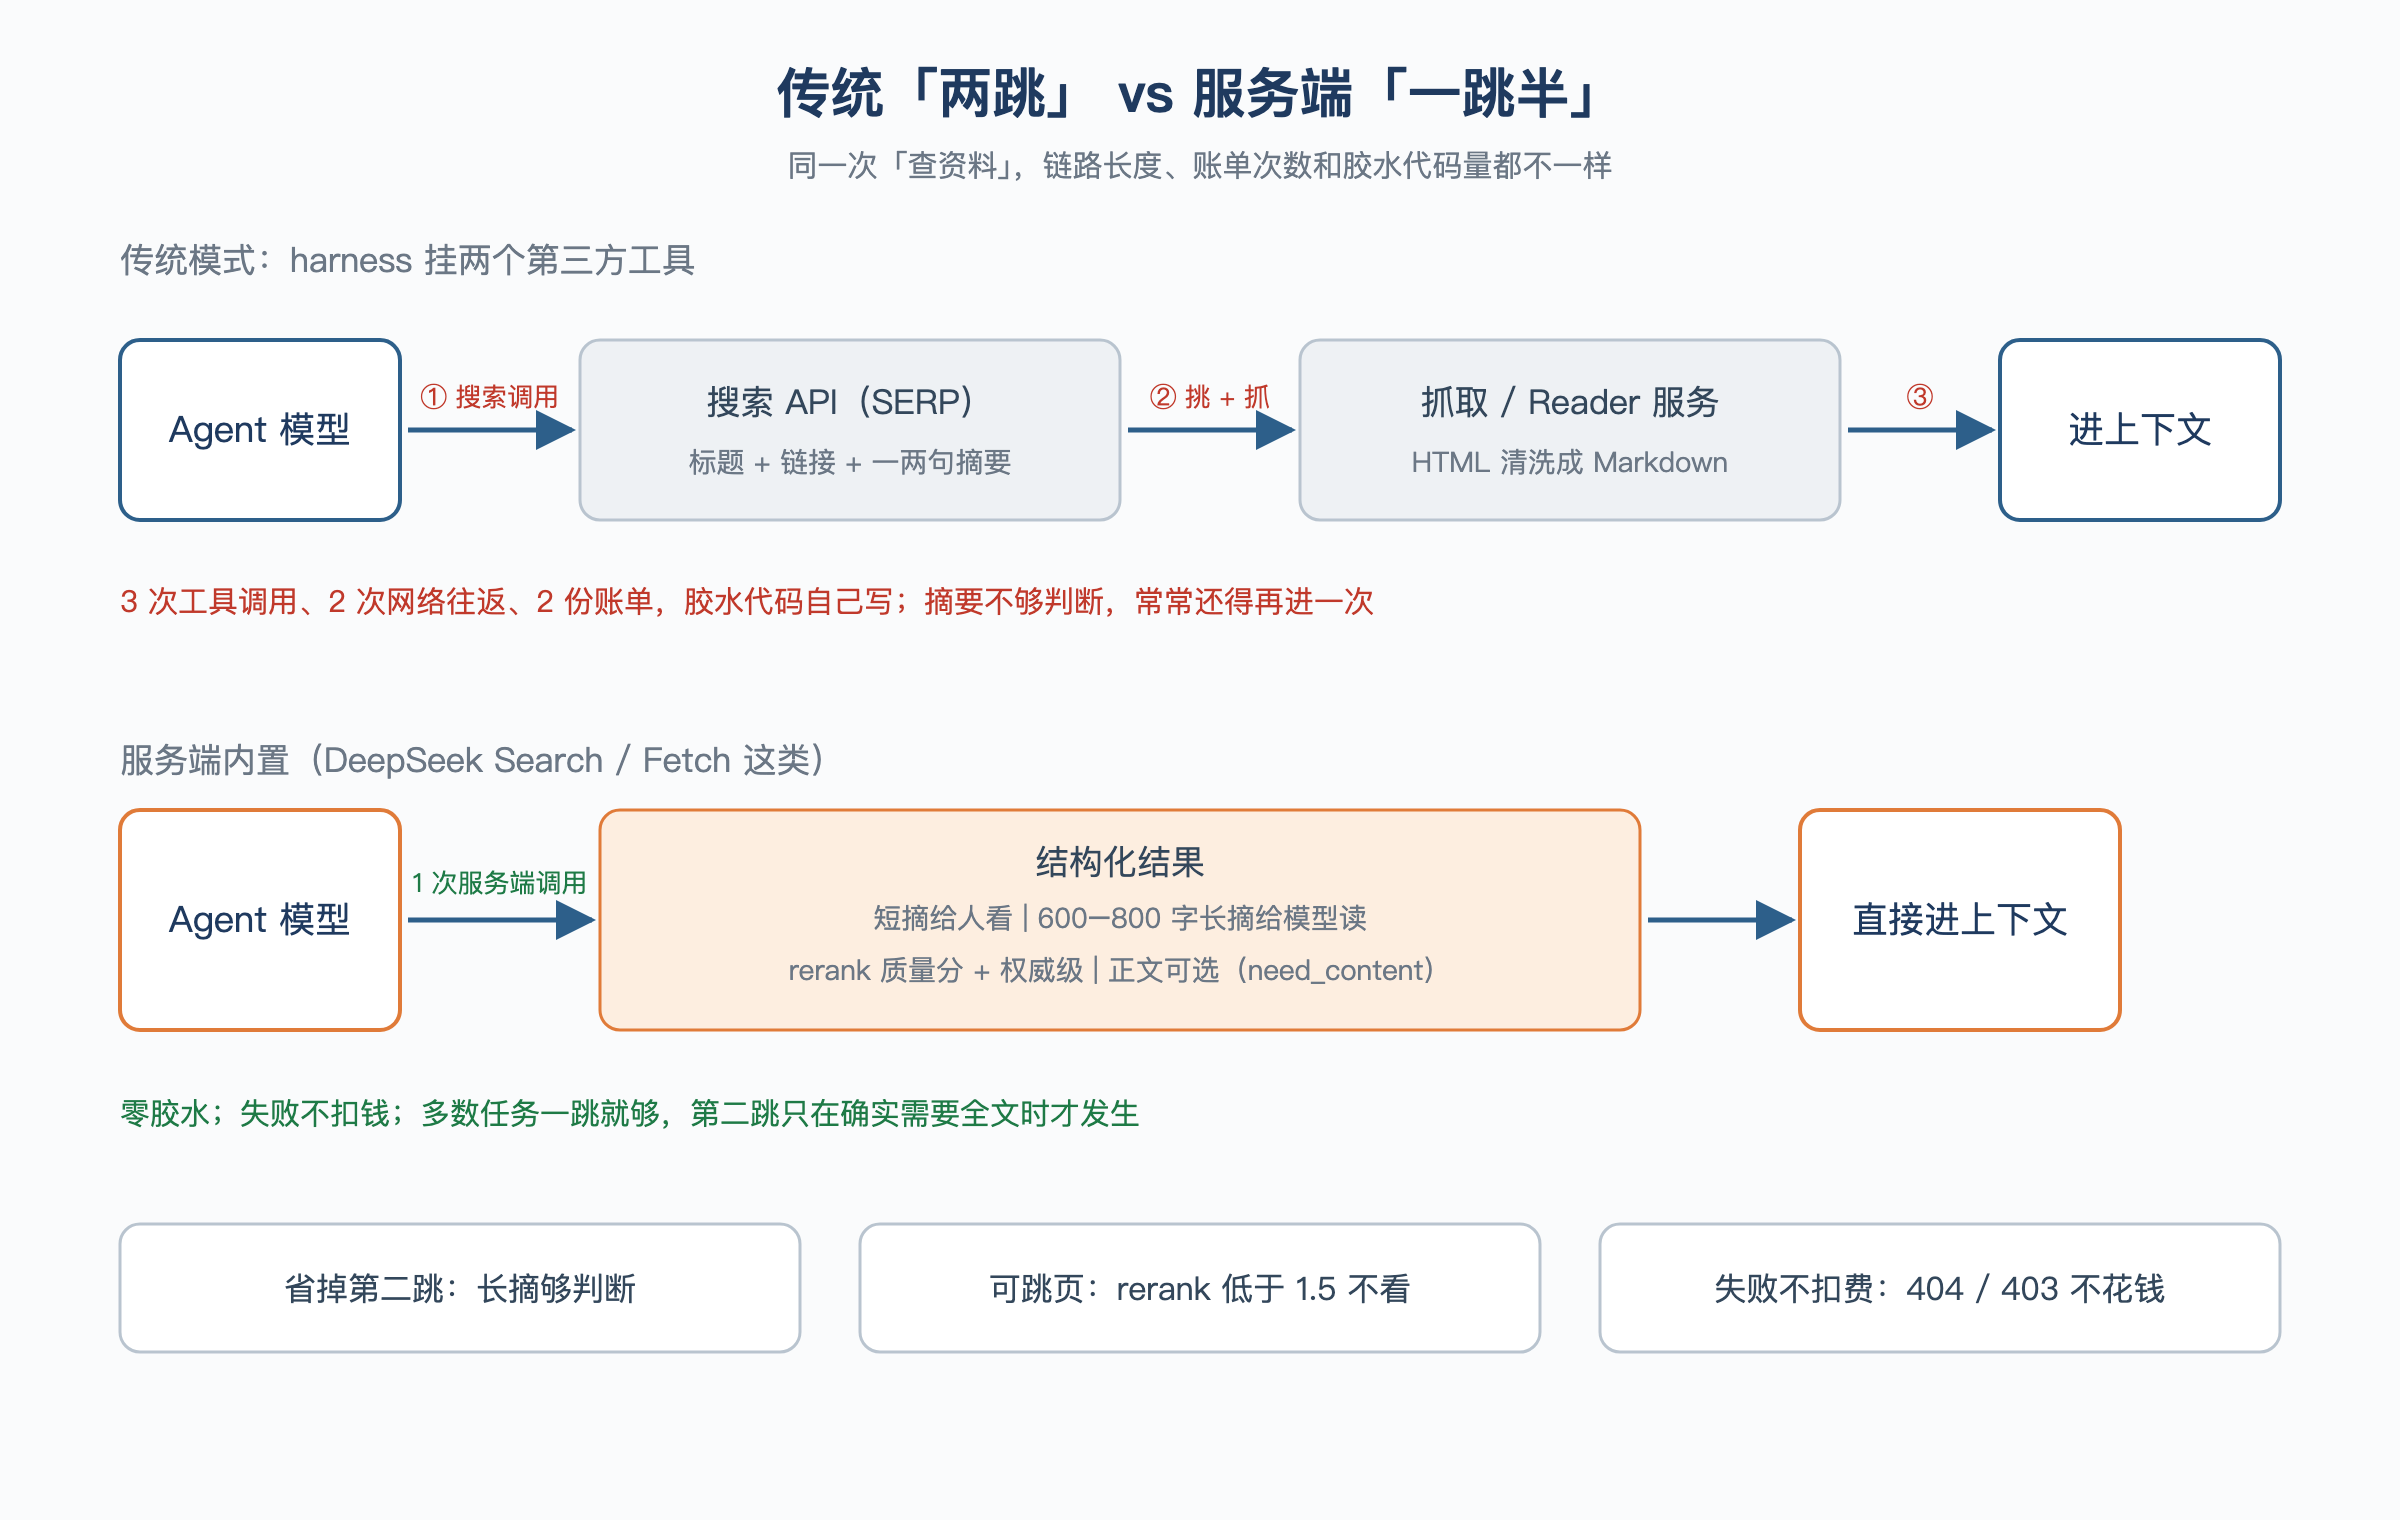
主流 Agent 框架的标配,是挂一个 websearch 工具(背后通常是 Brave、Serper、Tavily 这类搜索 API),再加一个 webfetch 工具(背后是 Jina Reader、Firecrawl 这类网页转 Markdown 服务,或 Playwright 无头浏览器)。
跑起来是一条链:
- 搜索接口返回「标题 + 链接 + 一两句摘要」的目录卡片;
- 模型从十条蓝链里挑一条;
- 再发起第二次工具调用去抓 URL;
- 抓回 HTML,清洗、截断,塞进上下文。
每一跳都是一次工具调用、一次网络往返、一份独立账单。
打个比方:传统模式像给模型一台图书馆检索机——它只能查到「此书在架、位于第三排」,读不读得动、值不值得去取,全靠自己跑三趟。Search 加 Fetch、结果自带长摘要和全文的模式,更像配了一位馆员:检索结果里附了 800 字读书报告,标了可靠度分数,你要全文,他当场念给你听。
四条本质提升
- 搜索结果自带「给模型读的版本」。
snippet给人看,summary给模型读,content全文可选。600 到 800 字符的长摘要,意味着很多任务一次搜索就够了,第二跳 fetch 可以整段省掉。传统 SERP 接口给的一两句摘要,基本不够做判断。 - 质量信号是引擎的内部数字。
rerank_score和authority是搜索引擎排序时的内生信号,第三方 SERP 通常不给,或者只给不可比的粗分。有了它们,Agent 可以「不开卷先跳页」——1.5 分以下的结果直接不看,把抓取预算花在刀刃上。 - 搜与抓同源。 同一个索引、同一份鉴权、同一次充值;Fetch 直接吐 Markdown,HTML 解析、正文抽取、反爬处理都在厂商侧完成。口径提醒:文档明确说结果受目标站点可用性与访问策略影响,反爬硬的页面照样 403/404,这不等于万能浏览器。
- 失败不花钱,内置免胶水。 按成功请求计费,再加上 server 端工具调用模式——在 Claude Code、Codex、dsh 里,模型可以自动触发搜索,开发者一行胶水代码都不用写。
这四条里,第 1 和第 2 条是「自研索引」才给得出的东西:套壳别人搜索的厂商,很难拿到内部排序分再转卖。这才是这次发布真正扎人的地方。
三、六套方案:各家怎么让 Agent「看网页」
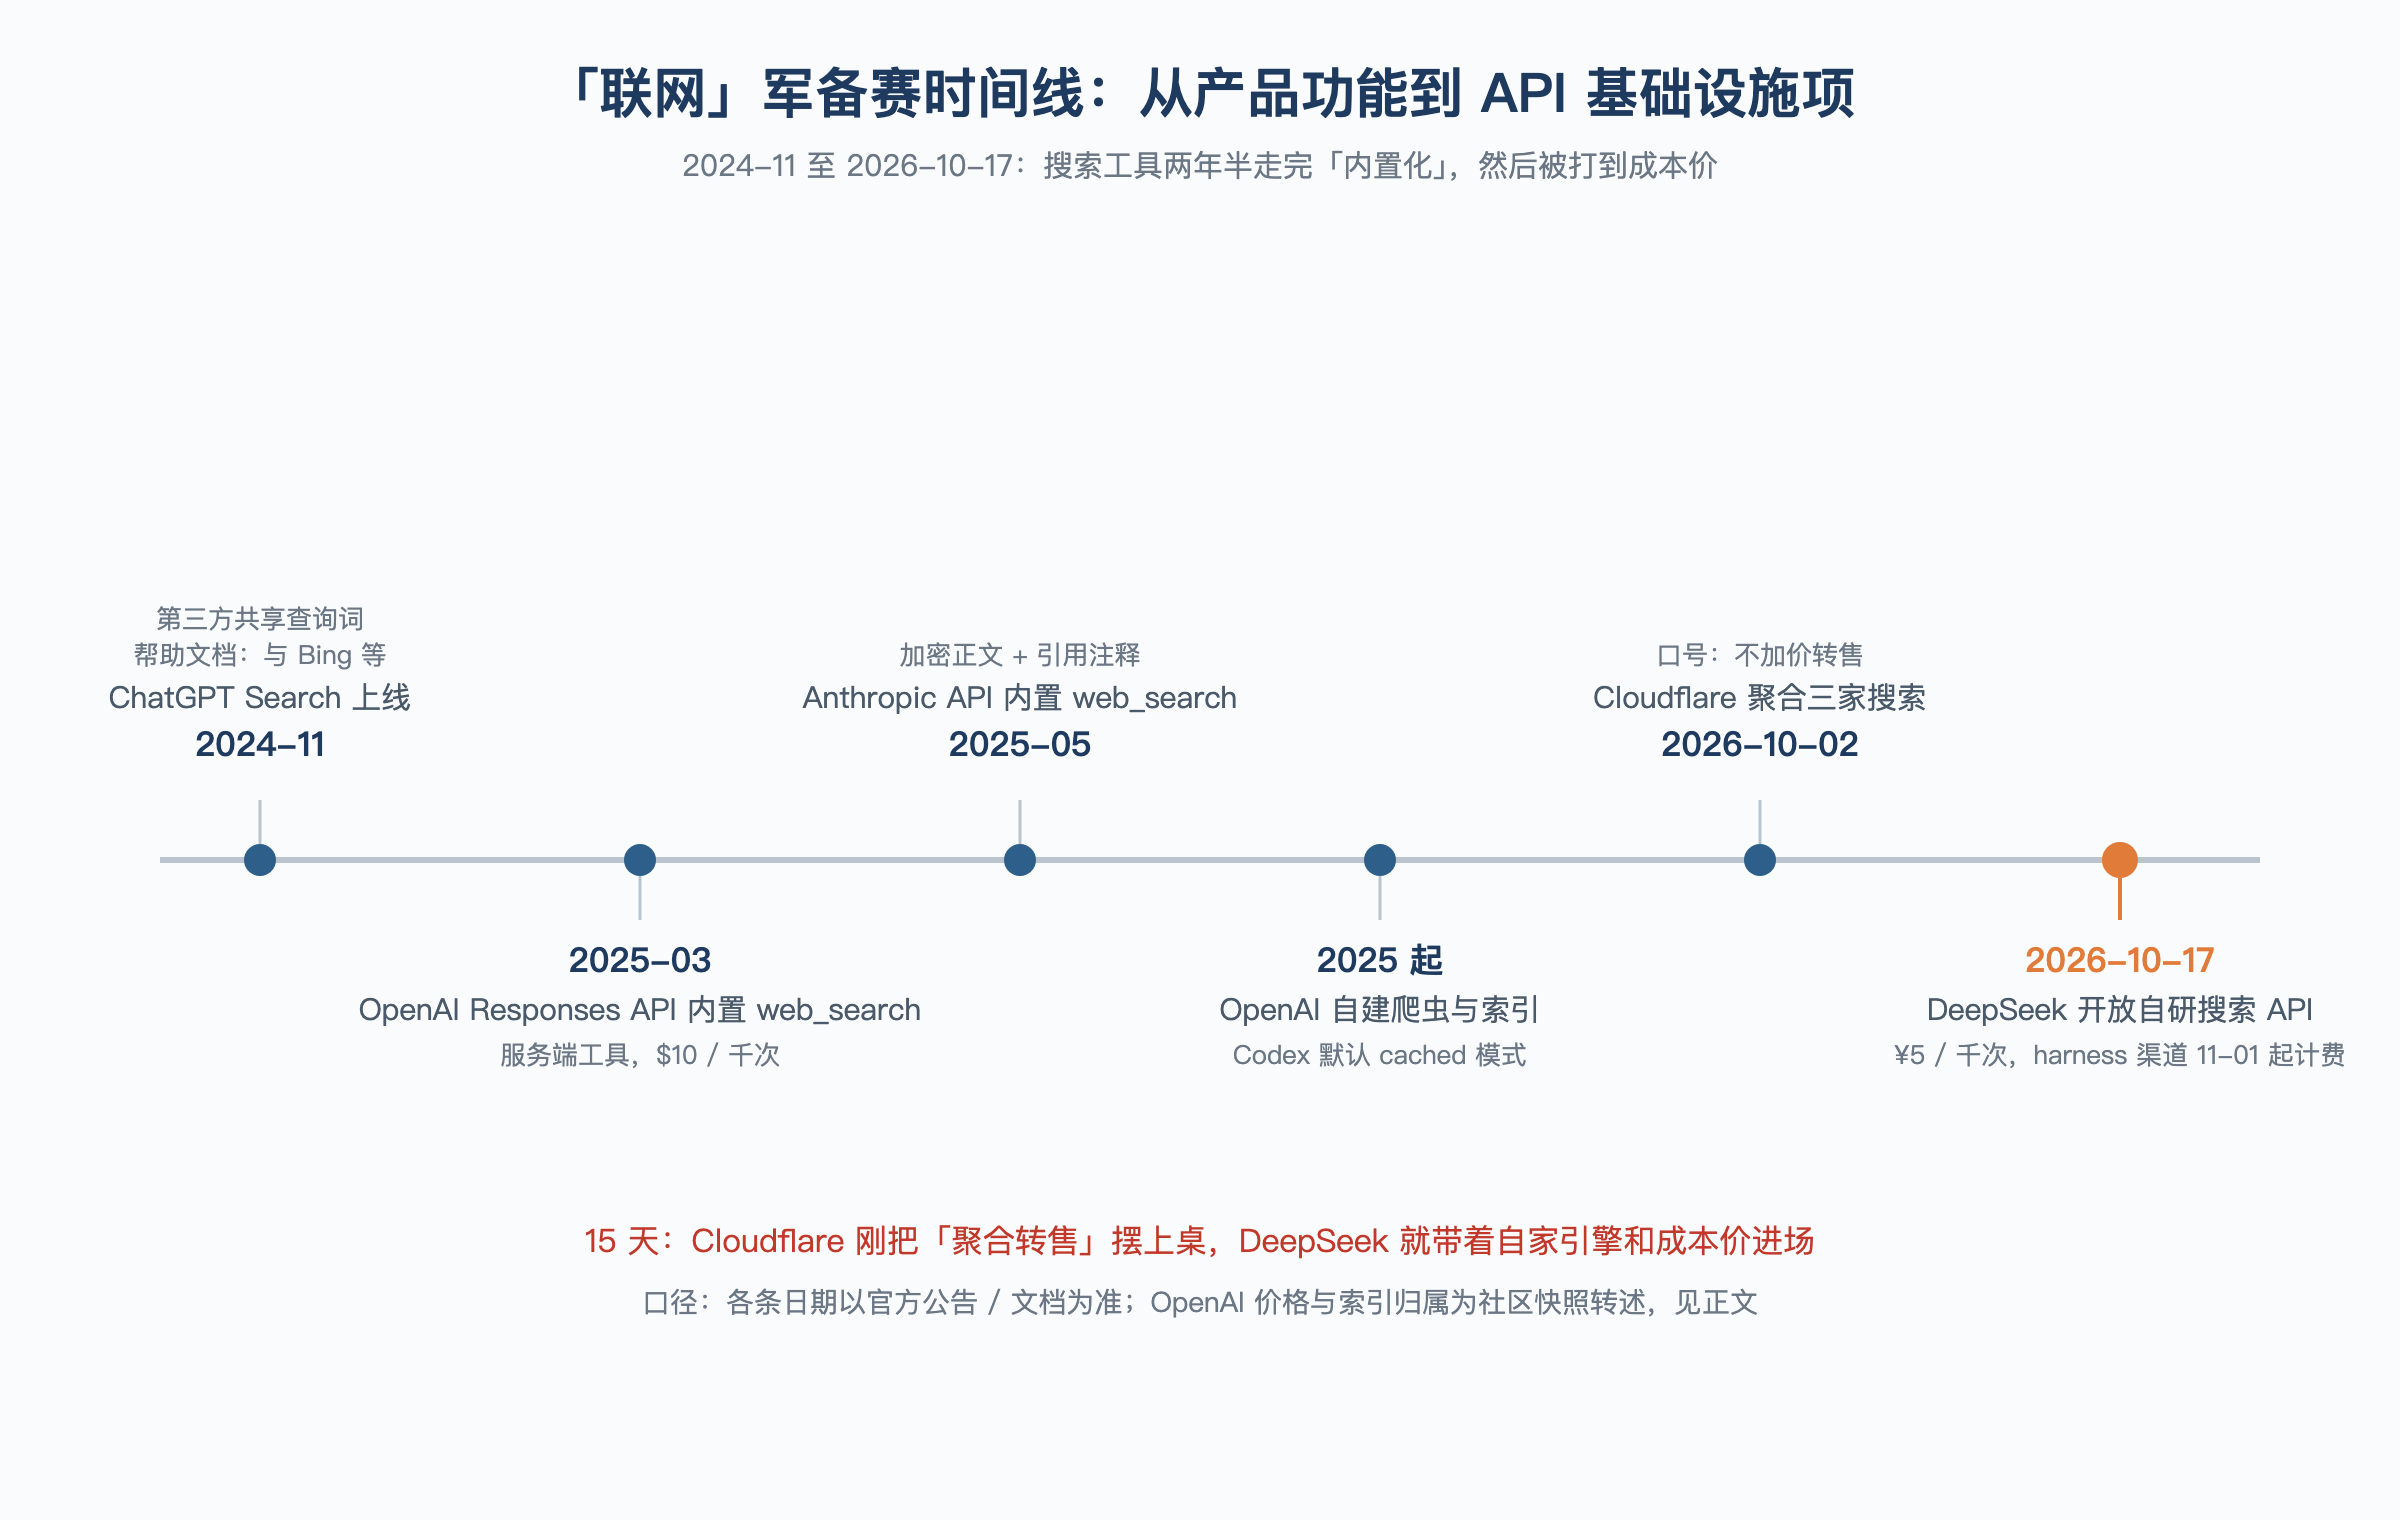
用四个问题给每家对账:搜索由谁触发、返回什么、谁把网页变正文、按什么计费。
| 方案 | 主推形态 | 搜索返回 | 正文抓取 | 价格与限制 |
|---|---|---|---|---|
| DeepSeek + dsh | 服务端工具 | 结构化结果 + 600–800 字符摘要 + 质量分 | Fetch 直出 Markdown | 5 元/千次;11 月 1 日前 harness 渠道免费;5 QPS |
| Claude + Claude Code | 客户端两件套,API 侧另有服务端工具 | 标题 + URL | WebFetch 转 Markdown,独立模型调用抽取 | $10/千次 + token |
| ChatGPT + Codex | 服务端 | 带 url_citation 的答案 + 动作记录 | 服务端 open_page | $10/千次 + 内容 token(社区快照) |
| GLM + ZCode | 服务端 / 独立 API | 标题、链接、正文级摘要、站点、时间、引用号 | Web Reader 转 Markdown | 10 元/千次 |
| 火山 Seed + 方舟/扣子 | 服务端插件 + 独立 API | 带引用,支持中文垂类来源 | 豆包搜索 API 可带正文 | 4 元/千次,每月 2 万次免费;垂类 6 元/千次 |
| Google Gemini | 服务端 | groundingMetadata,句子级引用 | url_context 取正文 | Gemini 3 约 $14/千次查询;2.5 约 $35/千个 grounded prompt |
1. DeepSeek + dsh(含 Claude Code、Codex 接入)
DeepSeek 自家的开源 harness dsh,以及经兼容层接入的 Claude Code 和 Codex,走的都是 server 端工具调用:客户端照常发请求,DeepSeek 在服务端代执行搜索。官方文档逐字确认支持 Anthropic 协议的 server_tool_use 与 web_search_tool_result 内容块。
一句话点评:接入最省事、单条最便宜(5 元/千次),11 月 1 日前 harness 渠道免费;代价是账号级 5 QPS 限频,工作流里狂并行会被 429。
2. Claude + Claude Code
Claude Code 把搜索和抓取拆成两个客户端工具:
WebSearch向 Anthropic 的搜索后端发查询,但只返回标题和 URL 的裸链接列表;- 要不要点开由主模型决定,再调
WebFetch——抓页面、HTML 转 Markdown,然后用一次独立的模型调用按给定提示词抽取要点,单次最多读 10 万字符,结果缓存 15 分钟。
安全护栏做得很细:拒绝 localhost、HTTP 自动升级 HTTPS、跨主机重定向不跟随。
Claude 的 API 侧另有服务端 web_search 工具,返回的正文是加密的(encrypted_content,续聊时必须原样回传、由服务端解密)。
一句话点评:形态最全、工程护栏最细的一档;但 Anthropic 从未披露搜索后端是谁,社区普遍猜测是 Brave(第三方推测,官方未证实)。每千次搜索 10 美元,外加 token 费,是行业「标准价」。
3. ChatGPT + Codex
OpenAI 是全链路服务端化的代表。Responses API 的 web_search 工具由模型在服务端自主决定搜不搜,输出不是链接列表,而是带 url_citation 注释的答案,外加 search、open_page、find_in_page 三种动作记录——读页、页内定位也在服务端完成。
历史脉络:
- 2024 年 ChatGPT Search 上线时,帮助文档明说会和「第三方搜索供应商(如 Bing)」共享去标识化的查询词;
- 2025 年起,OpenAI 转向自家爬虫与索引,Azure 托管渠道则仍明示走 Bing。
Codex 命令行里搜索默认开启,但走 cached 模式——查 OpenAI 自维护索引,不实时抓网页;要实时搜需显式设成 live。新版 Codex 的 web.run 工具甚至能 open、click、find、screenshot,等于服务端里藏了一个浏览器代理。
一句话点评:答案是搜索,拿到的是引用式文本而不是原料。计费口径为社区从官方定价页抄录的 $10/千次加内容 token(本次未能直连官方页核验,注明为快照转述)。
4. GLM + ZCode
智谱把搜索做成了三件套:
- chat API 内置
web_search服务端工具; - 独立的 Web Search API,引擎代号
search-prime,官方称自研高级引擎,返回「标题 + 链接 + 正文级摘要 + 站点 + 发布时间 + 引用编号」的结构化列表——形态和 DeepSeek 的 Search 最像; - 抓取侧有姊妹工具 Web Reader,服务端把 URL 转成 Markdown。
定价 0.01 元/次(10 元/千次,口径:docs.z.ai 官方定价页)。各家 Agent 平台接 GLM Coding Plan 时走的是「provider-native 透传」——搜索由模型服务端执行,harness 只负责触发和展示。
一句话点评:返回粒度和 DeepSeek 同路,价格是标准价档。
5. 火山 Seed + 方舟/扣子
豆包/Seed 系列的联网方案分两条线。
模型内置线:方舟的 Responses API 声明 web_search 插件后,模型在服务端自主搜索,后端是字节自建索引。特色是能把头条图文、抖音百科、墨迹天气作为可选来源,输出带引用注释(含站点名、摘要、发布时间、logo);usage 字段会精确报告每种来源各调了几次,计费透明到可以直接进成本账单。
价格:联网资源 4 元/千次,每月送 2 万次免费额度;垂类来源 6 元/千次(口径:方舟官方定价页镜像转述)。
两个计费坑:
- 按「关键词调用次数」计,而非「请求轮次」,单轮并行关键词会直接乘进账单;
- Chat Completions 协议不支持该插件,必须走 Responses API。
独立 API 线:豆包搜索 API 可以让搜索结果直接带正文级内容(text 或 markdown),另有封装成插件进扣子、封装成 Skill 和 MCP 进各家 harness。官方案例库里 byted-web-search 这份 Skill 的说明里写了一句大实话:Claude Code 的原生搜索只服务 Claude 系模型,第三方模型要靠这类 harness 工具补上搜索能力。
一句话点评:价格国内最低一档、来源特色最重(中文垂类),订阅免费额度对轻量用户近乎白送。
6. Google Gemini
google_search 工具直接调 Google 自家索引:响应带 groundingMetadata——检索块、句子级引用对齐(每句话标出被哪个来源支持)、后续搜索建议。
抓取侧的 url_context 工具在服务端取 URL 正文进上下文,不加收工具费,只按输入 token 计。
计费:
- Gemini 2.5 时代,每千个 grounded prompt 约 $35,每天 1500 次免费;
- Gemini 3 时代,改为按实际执行的搜索查询数计,约 $14/千次,每月 5000 次免费。
「按查询数」和 DeepSeek 的「按成功请求数」是同一种精细化方向。口径:2026-09 社区快照转录官方定价页,本次未能直连核验。
一句话点评:引用质量天花板,价格也是天花板。
一个一眼能看出的格局
2026 年,搜索正在从 harness 挂在外面的工具,迁进模型服务端的肚子里——六家里五家的主推形态都是 server-side tool。
DeepSeek 这次的动作之所以扎眼,是因为它把这个趋势里最贵的环节(自研索引),标了个最便宜的价。
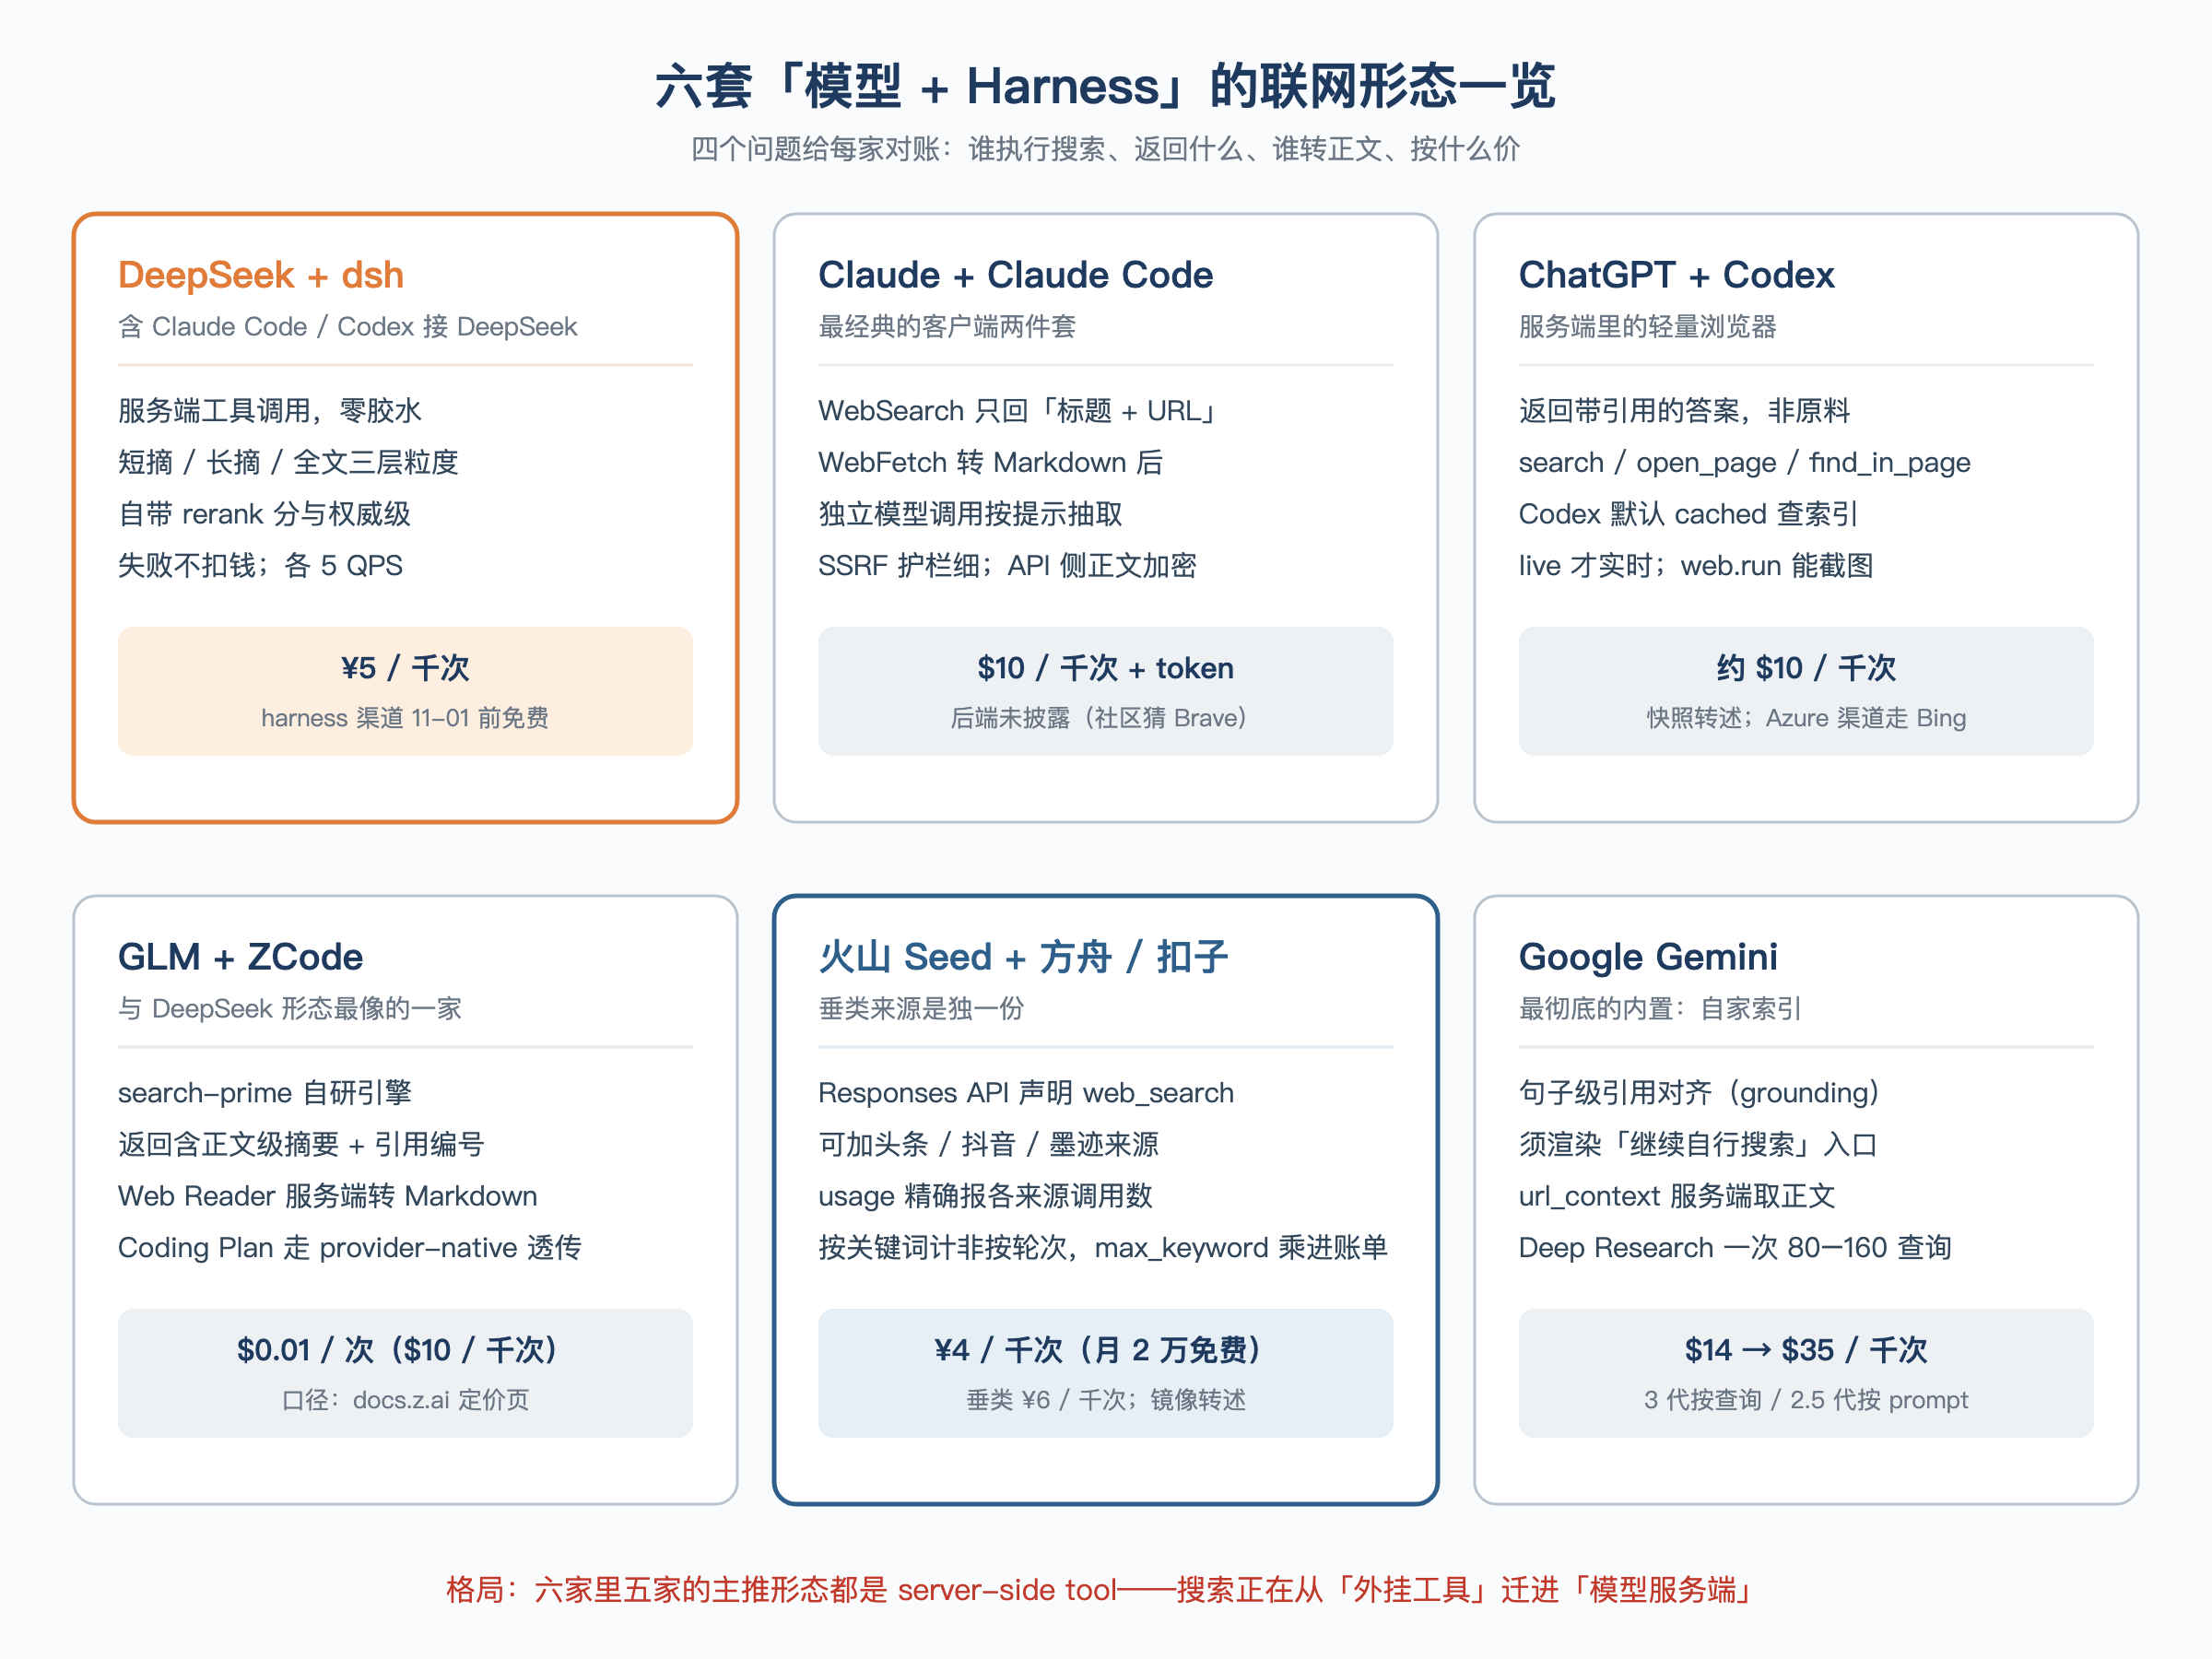
第三方转售链路的夹缝也在变窄:Cloudflare 10 月 2 日刚上线聚合三家搜索供应商的 Web Search API,宣传「不加价转售」;15 天后,DeepSeek 带着自家引擎和 $0.75 进场。搜索即商品的战争,两周内就打到了成本价。
四、为什么每家都要自己长「眼睛」
机制一:上下文工程决定上限,搜索是输入侧的最大杠杆
Agent 时代,模型之间的差距越来越多是「喂进上下文的东西」的差距。检索质量差,再强的模型也只能拿二手残缺信息做判断。搜索结果的摘要长度、正文粒度、质量分这些「对模型友好」的设计,直接影响下游每一步推理的地基。所以这件事套壳做不好,必须自己长。
机制二:数据闭环,搜索日志是 Agent 后训练的原料
把 DeepSeek 招聘页(talent.deepseek.com,检索于 2026-10-17)上搜索团队的使命原文摆出来,比任何解读都直接:
搜索是 AGI 感知世界的原生感官。我们正在打造下一代 AI 原生的通用搜索引擎,它不再只是返回十条蓝色链接。
目标写明「为 Agent 提供更强大的信息检索工具」。自己跑搜索,才能拿到「模型怎么用搜索结果」的全链路数据——这正是 Agent 能力军备竞赛最饥渴的训练原料。
机制三:定价权
每千次搜索卖 10 美元,和卖 5 块人民币,背后是「有没有自己的索引」。没有,就要给 Brave、Serper 们交中间商差价;有,就能像 DeepSeek 这样把成本价打出来,顺便用「失败不计费」把可靠性也变成卖点。
机制四:军备赛时间表
- 2025 年 3 月:OpenAI Responses API 带出服务端搜索;
- 2025 年 5 月:Anthropic API 上线
web_search; - 2026 年 10 月:Cloudflare 聚合入场;
- 2026 年 10 月 17 日:DeepSeek 搜索 API 化。
搜索工具已经从「产品功能」变成了「模型 API 的基础设施项」——没有的一家都在补,有的一家都在降价。
五、自建 Agent 怎么选、怎么算账
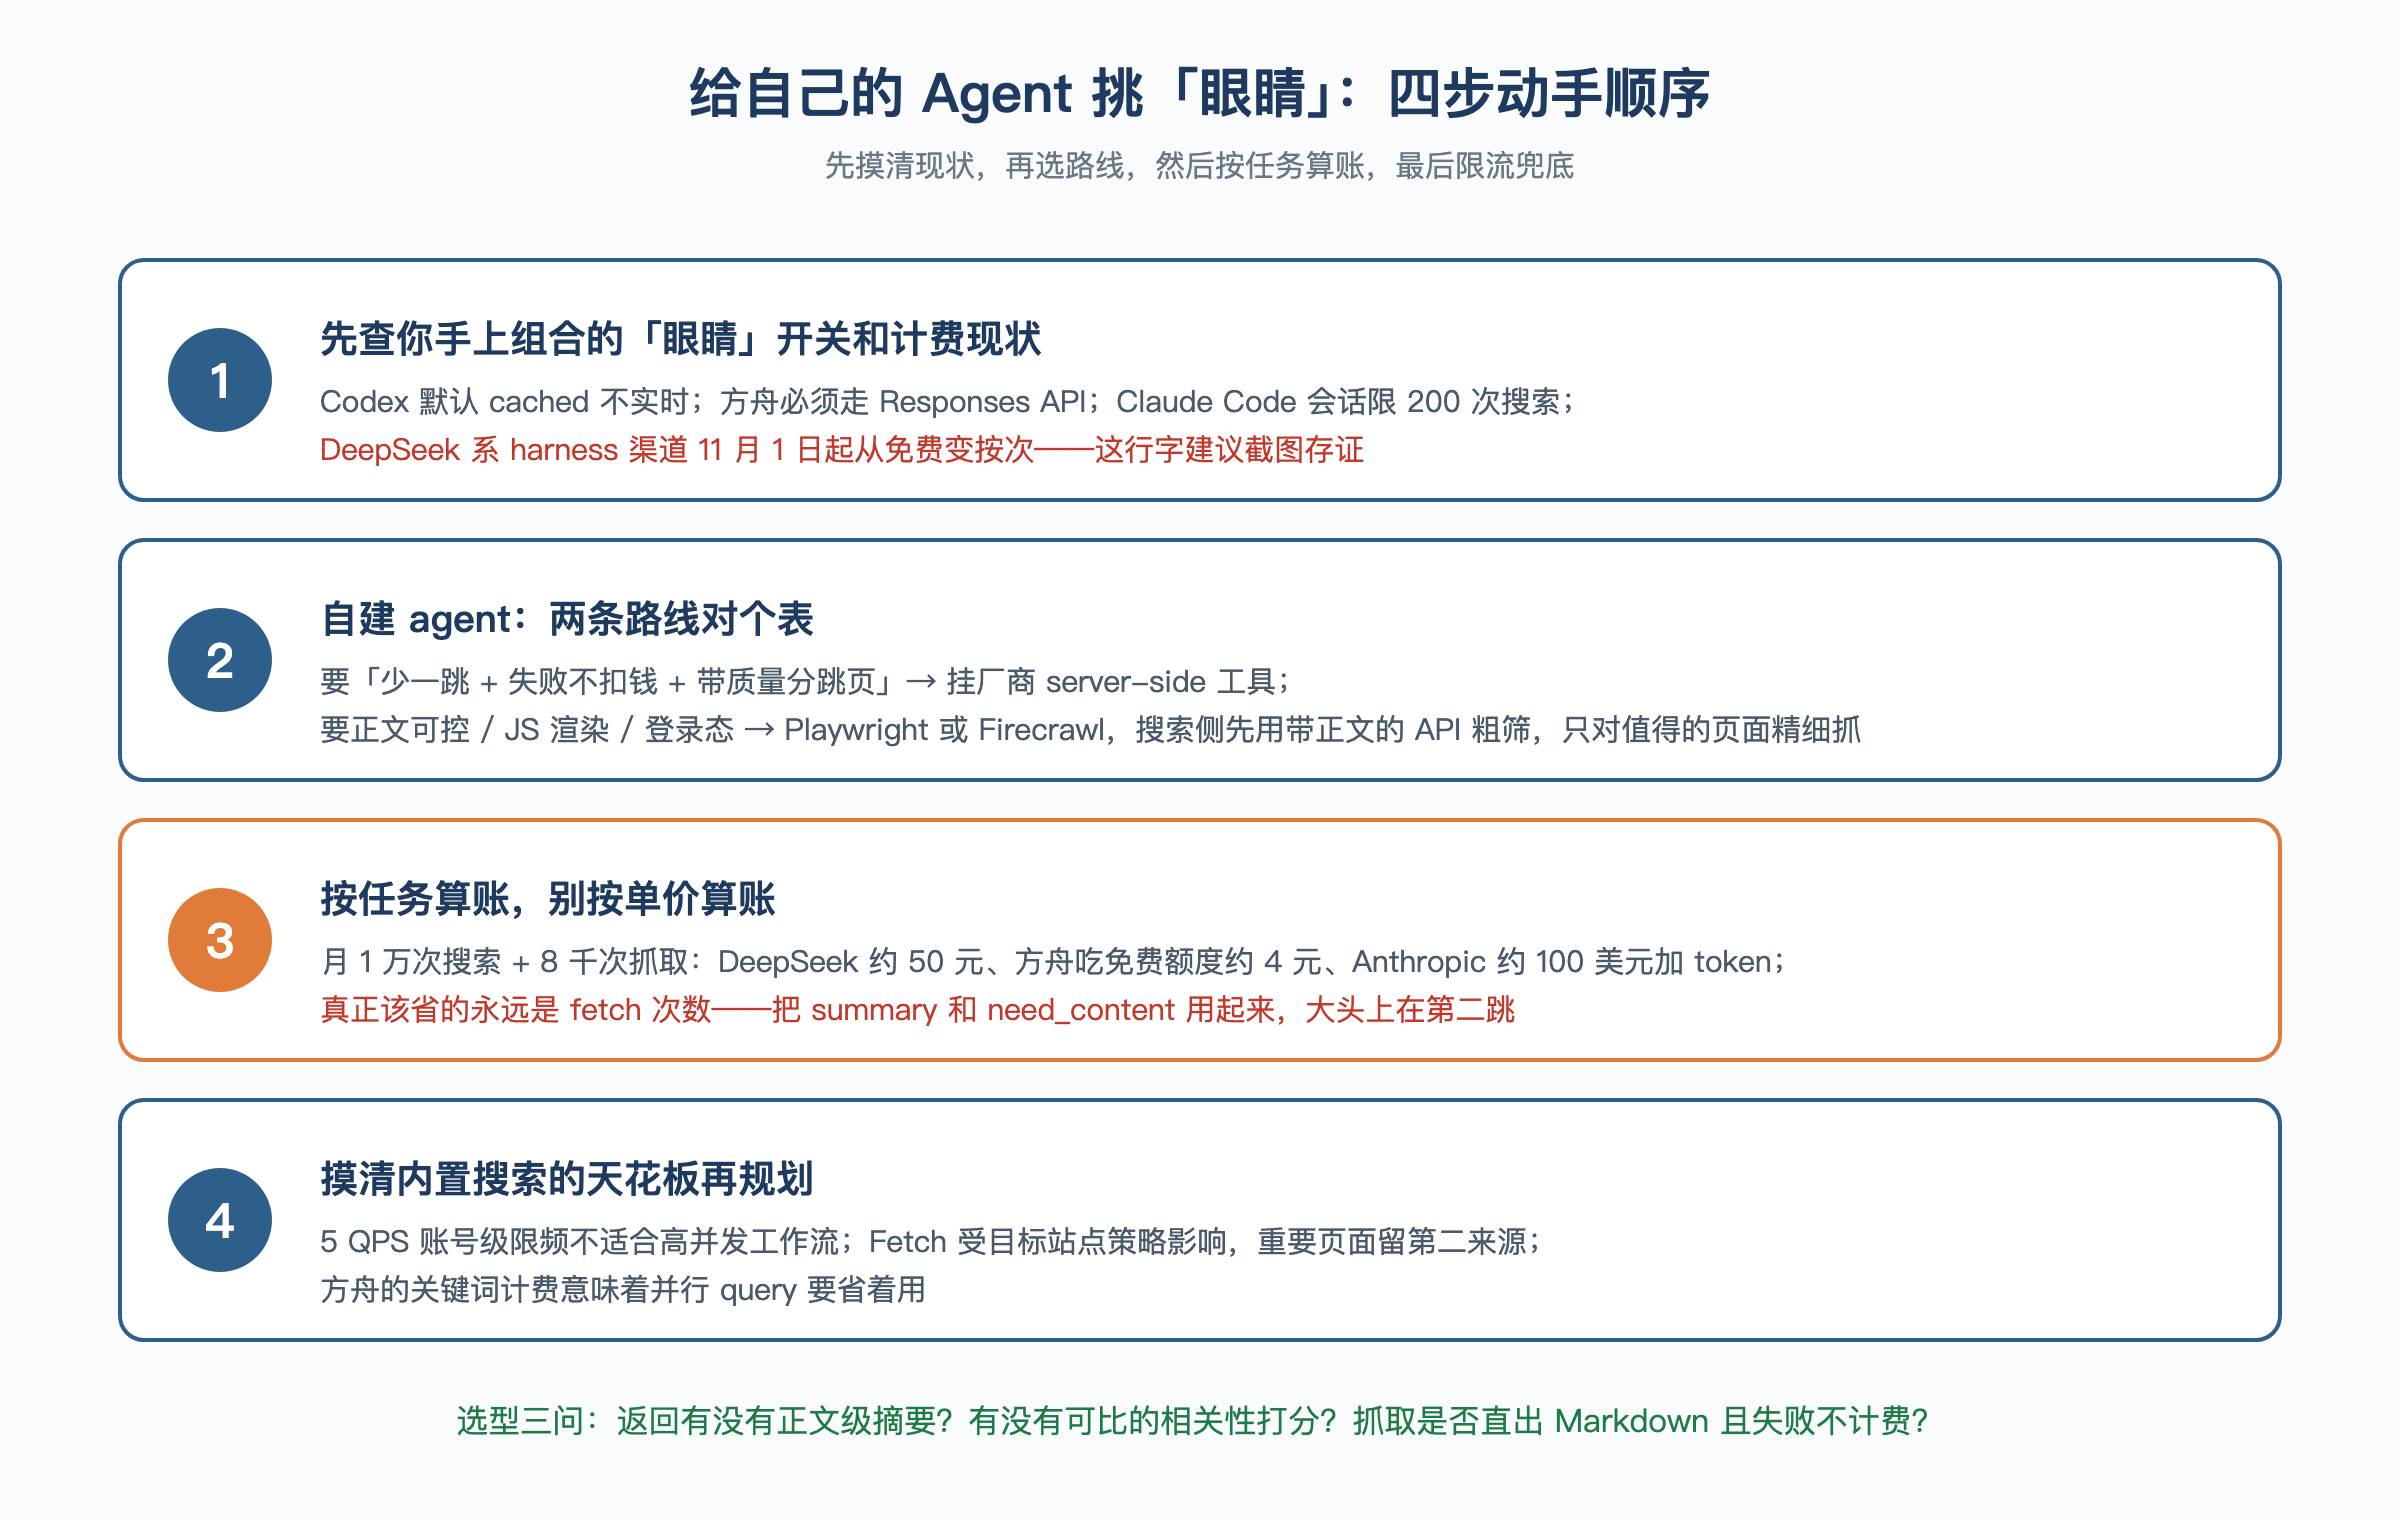
动手顺序:四步
- 先查手上组合的「眼睛」开关和计费现状。 Codex 默认 cached、不实时;方舟必须走 Responses API;DeepSeek 系 harness 渠道 11 月 1 日起变按次——这行字建议截图存证。
- 自建 Agent 时,两条路线对个表。 追求少一跳、失败不扣钱、带质量分跳页,挂厂商 server-side 工具;追求正文可控、JS 渲染、登录态,上 Playwright/Firecrawl。搜索侧先用带正文的 API 粗筛,只对值得的页面精细抓——两跳变「一跳半」。
- 按任务算账,别按单价算账。 以月 1 万次搜索为例:DeepSeek 约 50 元;火山方舟在每月 2 万次免费额度内为 0 元;Anthropic 约 100 美元再加 token。真正该省的永远是 fetch 次数。
- 摸清内置搜索的天花板。 5 QPS 不适合高并发工作流;Fetch 受目标站点策略影响;方舟按关键词计费,并行 query 要省着用。
三条忠告
别把搜索 API 当浏览器。 Search + Fetch 解决的是「读静态正文」。动态渲染、登录墙、验证码、要点击才展开的内容,仍然需要浏览器型工具。Codex 的 web.run 把 click 和 screenshot 都做进服务端,就是这个原因。
质量分要设阈值用。 拿到 rerank_score 和 authority 之后,给 Agent 写死「只看 1.5 分以上、权威级 3 以上优先」这类规则。搜索的钱省在「少抓」上,答案的质量提在「不喂垃圾」上。
把返回字段设计当选型题眼。 下次挑 Agent 平台的搜索能力,别只看「支持联网」四个字,问三个具体问题:返回里有没有正文级摘要?有没有可比的相关性打分?抓取是不是直出 Markdown 且失败不计费?三个都「没有」的,基本还是两跳套壳。
两个问题,留给评论区
同样给 Agent 一次网页搜索,DeepSeek 卖 $0.75/千次,Anthropic、OpenAI、智谱卖 $10/千次,十三倍价差摆在这。
A 队:搜索 API 正在变成水电煤,13 倍说明别人在收「中间商过路费」,全线迟早被打到骨折。
B 队:索引质量是一分钱一分货的生意,搜索给错信源的代价远大于那 9.25 美元。
你站哪队?说说你拿哪类任务做过对比。
还有一个更长远的问题:未来 Agent 的搜索能力,该长在「模型端」(服务端工具,模型自动触发,拿得到内部质量分),还是长在「harness 端」(平台挂第三方 API,可换源、可比价)?
如果把上一波 Managed Agents 之争理解为「手脚归谁」,那这次争的就是「眼睛归谁」。
参考资料
- DeepSeek 官方文档:网页搜索与抓取(api-docs.deepseek.com/zh-cn/guides/search,2026-10-17)
- DeepSeek V4.1 Flash 更新公告之「开放自研搜索 API」(news/news261017)
- DeepSeek 定价页
- Anthropic 协议兼容矩阵
- Claude Code 与 Codex 集成页
- DeepSeek 招聘页搜索团队 JD(talent.deepseek.com,2026-10-16)
- Hacker News:V4.1 Flash 发布讨论帖 50129121、50129045(2026-10-17);旧帖 46974853(2026-02)
- Anthropic 定价页($10/1K searches,实测核验)
- Claude Code 工具参考(code.claude.com/docs/en/tools-reference)
- Claude API
web_search/web_fetch文档(经社区调研笔记转录,官方页区域受限) - OpenAI:Codex 源码与文档(cached/live 模式);Responses API
web_search(定价为社区快照转录,未直连核验) - 智谱 Z.ai 官方文档:web-search、web-reader、定价页(docs.z.ai)
- 火山方舟:联网内容插件与定价(docs.volcengine.com 82379,经镜像转录)
- 豆包搜索 MCP/API(github.com/volcengine/mcp-server)
- byted-web-search Skill(github.com/bytedance/agentkit-samples)
- Google Gemini:
google_search与url_context(经 2026-09 社区定价快照转录,官方页直连超时) - 第三方锚点:Cloudflare Web Search API 公告(2026-10-02);Exa、Tavily、Serper、Firecrawl 定价页(实测抓取);Jina Reader(GitHub);Brave 价格为社区转述,未官方核验
大家在聊 (0)
加载评论中...
还没有人留言
快来抢占沙发